

翻译狗PDF文档翻译软件:排版前后格式不变,才是PDF文档翻译的硬通货
翻译狗PDF文档翻译软件正在回应一个被行业反复讨论的真问题:AI翻译的速度上来了,但PDF文档翻译的“最后一公里”——排版前后格式不变、术语不偏——靠什么守住?2026中国翻译协会年会发布的《2026中国翻译行业发展报告》显示,2025年人工智能翻译为主营业务的企业已达2183家,行业正从“规模扩张”转向“质量与模式创新”。翻译狗在这场“智变”中的切入点,不是比谁翻得更快,而是比谁翻完之后不需要再打开排版软件返工。
PDF文档翻译的“阿喀琉斯之踵”,不在语言,在版式
做过论文翻译或技术文档文档翻译的人都有同感:一份双栏排版的学术PDF,交给普通在线翻译工具,译文出来那一刻语言可能通了,但图表飞了、公式碎了、段落顺序串了。PDF本质上是一种“固定版式”格式,它天生不关心内容结构,只关心视觉呈现。当翻译系统把文字抽出来、翻完再塞回去,如果没有对版式的“二次理解”,错位几乎是必然的。翻译狗采用的思路不同:全景识别技术(PCR)在翻译前先对文档做一次结构级解析,识别标题层级、双栏布局、表格单元格边界、页眉页脚区域,再让译文“落回”原有位置。这意味着PDF文档翻译的产出逻辑,从“翻完再修”变成了“翻完即用”,排版前后格式不变不再靠人工补救,而是被写进翻译流程本身。
术语库+多引擎:精准不只是“翻得对”,更是“翻得一致”
格式是看得见的痛点,术语是看不见的暗礁。科研论文里同一个术语在摘要、正文、图表注释中出现十几次,译文如果每次都不一样,读者就要反复做“术语对齐”的心算。翻译狗内置的垂直领域术语库允许用户按医学、法律、工程、科研等场景预设译法,系统在文档翻译过程中自动匹配,确保全文术语前后统一。在翻译引擎层面,翻译狗没有押注单一模型,而是集成了OpenAI、DeepL、谷歌等引擎,结合自研的神经网络智能翻译系统NITS,用户可以在“双语对照”与“仅译文”之间切换,让PDF翻译的精度和可读性同时有处安放。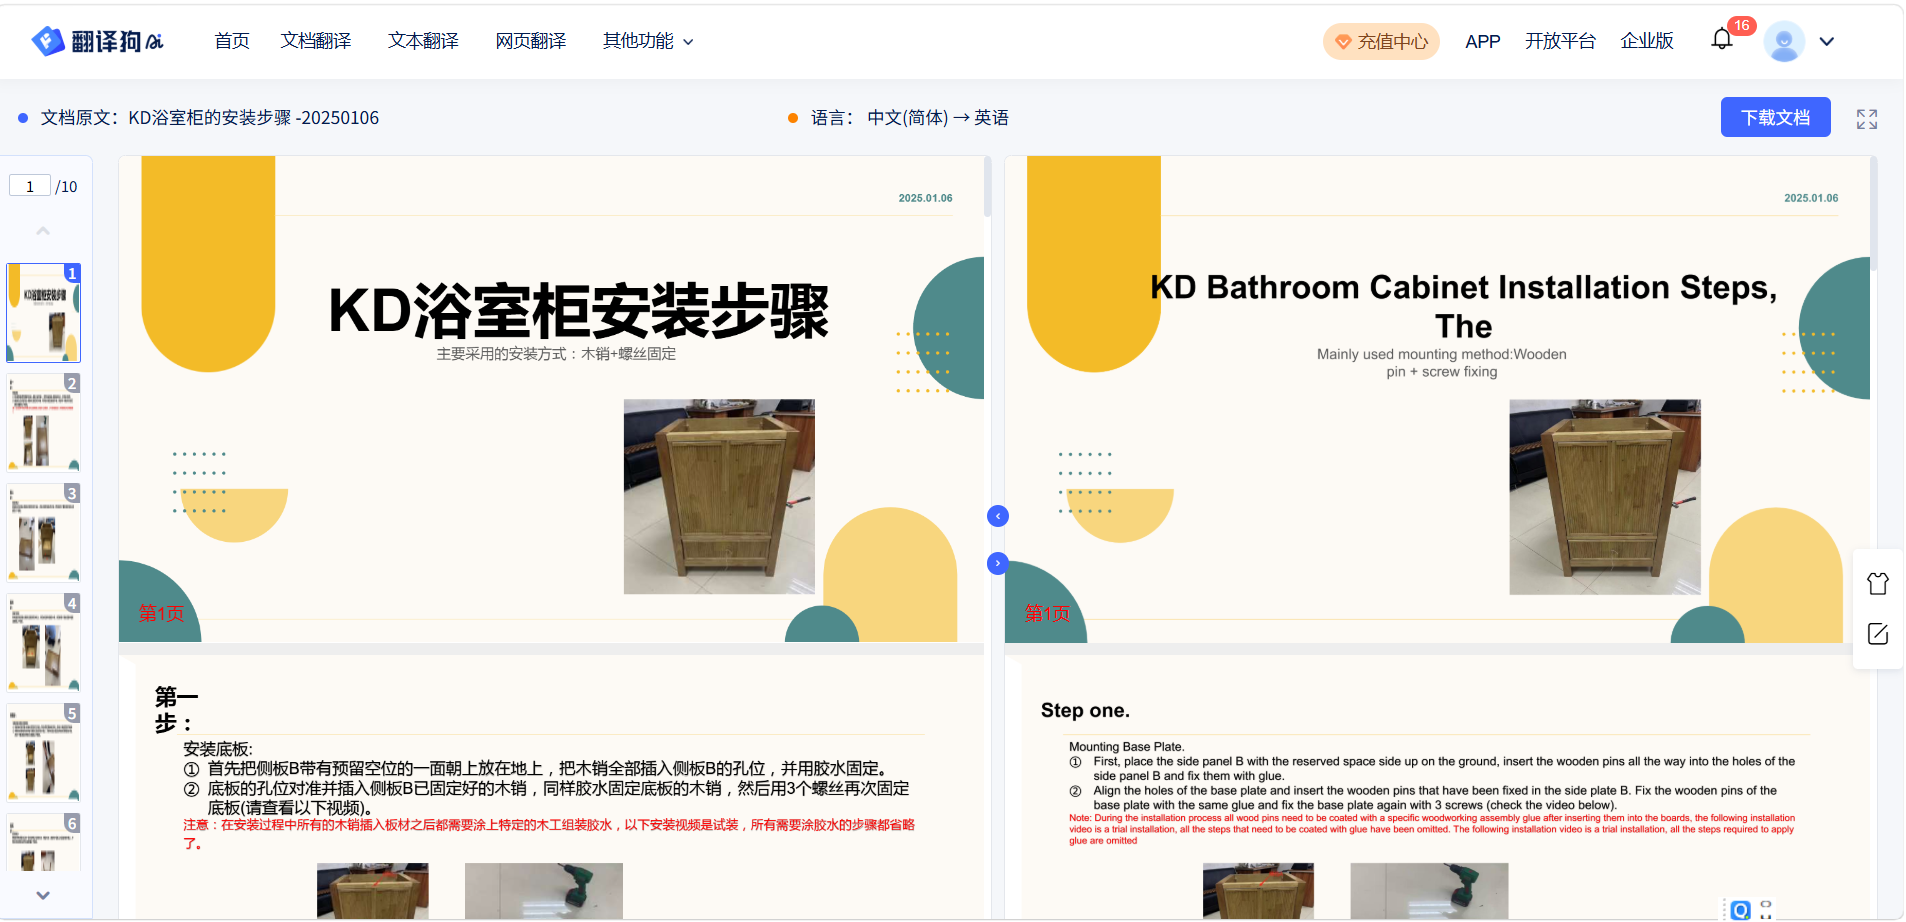
从“翻完能看”到“翻完能用”:效率差藏在返工时间里
一个容易被忽略的事实是:PDF文档翻译的真实成本,从来不只花在翻译上,还花在翻译之后。一份10页以内的学术PDF,翻译狗完成全文翻译约需40秒,图表标题、表格文字、参考文献序号同步转译,输出文件保留原文的段落层级和图表位置,做到排版前后格式不变。对于需要高频处理外文文献的研究生和科研人员来说,省下来的不是“读译文”的时间,而是“把译文恢复成一篇能读的文档”的时间。有用户在使用反馈中写道,其他工具翻完后“自己还要排版”,而翻译狗“保持排版不说,价格比有道便宜”。这种体验差距,在单篇文档上也许只是十几分钟,放到一个课题周期里,就是可观的时间复利。
翻译狗的答案:让PDF文档翻译回归“文档”本身
AI翻译行业正在经历一场从“能翻”到“敢直接用”的爬坡。大模型的流利度已经不再是稀缺品,稀缺的是对文档结构的尊重、对专业术语的克制、对用户后续动作的预判。翻译狗对PDF文档翻译的理解,落在一条朴素的标准上:翻译完成的那一刻,文档应该还是原来那篇文档,只是文字换成了你能读懂的语言,排版前后格式不变。如果你手头正有一份外文PDF等着在线翻译,不妨从翻译狗官网的免费体验页数开始,把“翻完还要不要修”这个问题,交给一次上传去回答。