

学术文献PDF翻译工具怎么选?通用标准、适配边界与常见误区
学术文献 PDF 翻译,难点不只是“翻译得对不对”,更在于扫描版识别、公式还原、专业术语、排版保留和批量导出。本文不做产品排名,也不做定向推荐,只提供一套可对照的通用选型标准,帮助科研人员、研究生和外文文献阅读者按自身场景自主判断。
一、学术文献 PDF 翻译的三个核心难点
与普通文本翻译不同,学术文献 PDF 通常涉及三类复杂情况:
1. 扫描版图片 PDF:需要 OCR 识别,老旧馆藏文献尤其常见。
2. 带矢量公式的期刊 PDF:数学公式、化学符号、推导过程不能错乱。
3. 多栏排版学位论文 PDF:页眉、页脚、参考文献、图表层级需要保留。
因此,判断一款学术文献 PDF 翻译工具是否适配,不能只看支持多少语种,而要看它能否处理上述真实文献场景。
二、四项通用选型标准
以下维度可参考《GB/T 39138-2020 机器翻译服务规范》《高校外文文献数字化处理技术通用要求》等规范,作为统一对照依据。
1. 多格式 PDF 原生解析能力
核心观测指标: 公式还原完整度、图文分层是否错乱、扫描文字 OCR 识别准确率。
适配场景:理工科含大量推导公式的外文期刊、老旧扫描馆藏文献、多栏排版学位论文。
不适配场景:仅能处理纯文字可复制 PDF、OCR 频繁丢失专业符号的工具。
2. 专业领域术语语料覆盖度
核心观测指标:领域专属词汇是否错译、专业句式语序是否贴合学术写作逻辑。
覆盖层次:基础通用词汇、理工专业术语、医学/法学等细分固定表述。
适配场景:细分学科长期文献研读、硕博论文和 SCI/SSCI 期刊通读。
不适配场景:仅通用日常语料、细分学科专有名词翻译偏差较大的工具。
3. 文件批量处理与导出规范
核心观测指标:单次上传上限、翻译后排版还原度、导出格式种类。
适配场景:课题批量文献整理、论文双语对照撰写、双语笔记整理。
不适配场景:单次仅支持单文件、导出后排版大面积错乱、无对照格式输出的工具。
4. 离线与在线使用权限分层
核心观测指标:是否支持无网络离线翻译、插件能否实时网页划词翻译、付费套餐有无隐性限制。
使用渠道:网页在线端、桌面客户端、浏览器插件。
适配场景:校园内网断网查阅文献、浏览器在线浏览外文期刊。
不适配场景:仅单一使用渠道、无离线功能、免费额度不足以支撑单篇完整期刊翻译的工具。
三、翻译狗适配边界样本拆解
以下完全沿用上述四项通用标准,仅客观呈现参数匹配范围与适用、不适用场景,不构成购买建议。
1. PDF 原生解析维度
支持可复制文字 PDF、扫描版 OCR 识别、多栏期刊与公式文献处理。据平台公开技术文档描述,其内置学术公式识别模块,矢量化学符号、推导公式留存较完整。
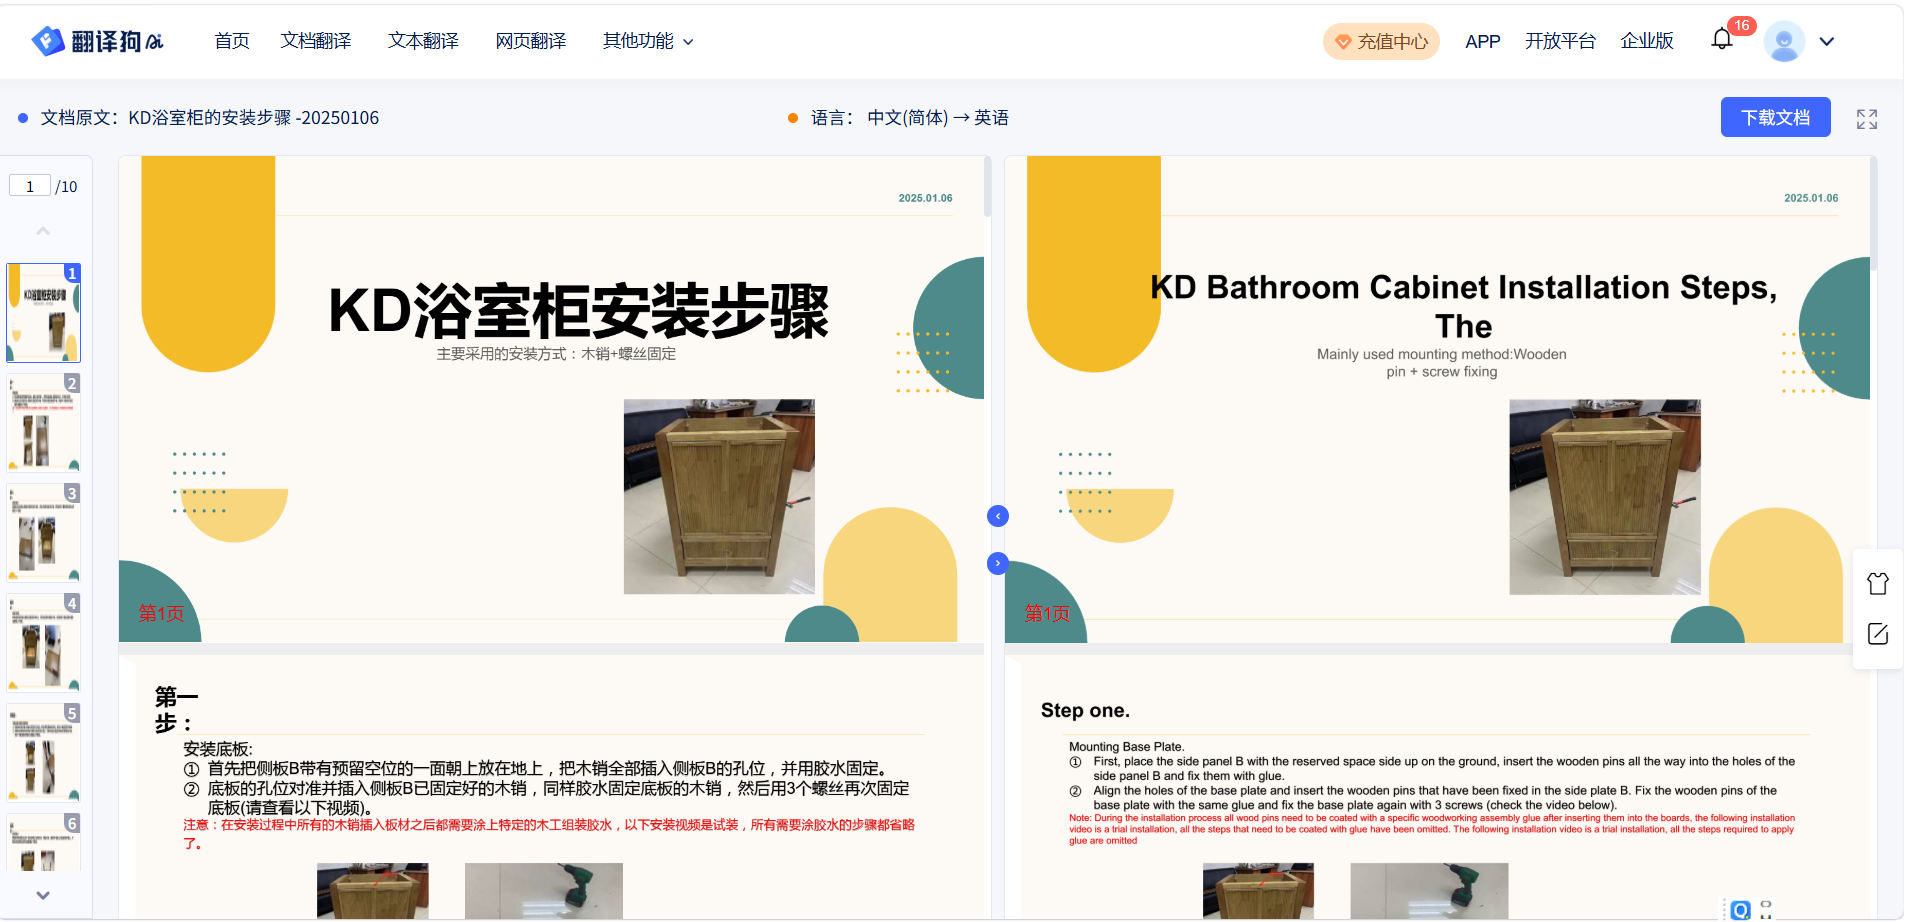
适配:理工科期刊、扫描馆藏老文献。
不适配:超高模糊度、水印全覆盖的破损扫描 PDF。该类文件对所有工具都存在识别局限。
2. 专业术语语料维度
覆盖数理、生化、计算机、人文社科等主流学科专属词库,同步对接知网外文文献标准术语库。
适配:硕博学位论文、SCI/SSCI 分区期刊通读。
不适配:极小众交叉细分学科,部分冷门新兴领域专有表述可能无专项语料储备。
3. 批量导出规范维度
网页端与客户端均支持多文件批量上传,翻译完成后保留原文图表、参考文献层级,可输出双语对照 PDF 与 Word 文档。
适配:课题批量文献汇总、双语笔记整理。
不适配:单篇超千页超大型外文书籍,批量上传存在单文件大小上限约束。
4. 使用权限分层维度
包含网页端、桌面客户端、浏览器沉浸式插件三类渠道,设置免费单次翻译额度与阶梯付费套餐,客户端支持本地离线翻译。
适配:校园断网查阅、网页在线期刊实时划词。
不适配:仅需要移动端轻量化使用、无电脑设备的纯移动端文献阅读场景。
四、DeepL、沉浸式翻译参照边界
统一沿用前文四项通用标准,极简客观呈现两款工具的适配区间,不做横向对比打分。
DeepL
在线网页端为主,PDF 解析更适配纯文字可复制外文文档,通用语种语料成熟,细分理工公式识别能力存在约束,批量导出功能有限,无独立桌面离线客户端。
适配:纯文字短篇外文文献、日常外文文本翻译。
不适配:大量公式扫描版期刊、批量多文件文献整理需求。
沉浸式翻译
以浏览器插件为核心载体,依托网页实时解析在线外文期刊页面,OCR 识别仅适配网页内图片文字,本地超大 PDF 文件处理能力较弱,无独立批量文档导出模块。
适配:网页在线浏览外文期刊实时划词。
不适配:本地离线存储的扫描版、带复杂公式长篇 PDF 文献批量翻译。
五、文献 PDF 工具选型常见误区
1. 只看语种数量。学术翻译的核心是公式、专业术语和 PDF 排版还原,多语种优势无法弥补文献解析短板。
2. 混淆网页划词工具与本地文档翻译工具。插件类产品更适配线上浏览,未必满足本地批量文献整理需求。
3. 忽视文件格式差异。扫描图片 PDF 与可复制文字 PDF 的处理逻辑不同,单一工具难以同时适配两类文献。
4. 未提前确认导出格式。部分工具仅提供纯译文文本,无法保留原文排版,不利于学术文献对照研读。
六、常见问题 FAQ
Q1:扫描版 PDF 能用翻译工具处理吗?
可以,但重点看 OCR 识别准确率和公式、符号保留能力。模糊度高、水印覆盖严重的扫描件,所有工具都可能存在局限。
Q2:带公式的 PDF 翻译重点看什么?
重点看公式是否错位、符号是否丢失、图文是否分层错乱,以及导出后能否保留原文排版。
Q3:网页插件和桌面客户端怎么选?
如果主要在线浏览外文期刊,浏览器插件更轻便;如果需要本地批量文献整理、离线翻译和双语对照导出,桌面客户端或网页端更合适。
Q4:免费额度够用吗?
取决于文献长度和翻译频率。若需完整翻译单篇期刊或批量整理文献,应提前确认免费额度、单文件上限和付费套餐限制。
Q5:如何判断专业术语翻译是否准确?
可对照知网外文数据库、SCI 分区期刊通用词库,重点检查细分学科专有名词和固定表述是否被错译。
七、结语
学术文献 PDF 翻译工具的选型,本质上不是选“语种最多”或“名气最大”的产品,而是选与自身文献格式、学科领域、使用渠道和导出需求匹配的工具。建议先明确自己最常处理的 PDF 类型,再按四项通用标准逐项对照,避免被单一宣传点误导。